
Quand Sol passe à côté d’un détail, est-ce que je monte son niveau de réflexion ou est-ce que je passe à Astra ? Pour répondre, j’ai rapproché les résultats des deux GPT-6.2, sortis le 17 novembre 2026, sur les mêmes épreuves et aux mêmes efforts. L’intérêt n’est pas de trouver un vainqueur pour tout faire : il est de savoir quel réglage essayer avant de payer plus ou d’attendre davantage.
Astra face à Sol : les cinq efforts, côte à côte
Le tableau combine le score arrondi de l’Intelligence Index v5.0.1 et le temps d’inférence par tâche, sur la même suite de neuf épreuves d’Artificial Analysis. Les mesures viennent des fiches Astra 6.2 et Sol 6.2, pas d’un test maison. Les minutes ne mesurent pas la durée d’une session Codex qui doit lire un dépôt, appeler des outils et attendre des tests.
| Effort | Astra 6.2 Score · temps | Sol 6.2 Score · temps |
|---|---|---|
| Low | 46 · 1,4 min | 41 · 1,4 min |
| Medium | 57 · 3,7 min | 53 · 3,1 min |
| High | 60 · 4,8 min | 55 · 4,3 min |
| xhigh | 62 · 5,9 min | 56 · 5,1 min |
| Max | 62 · 10,4 min | 57 · 7,9 min |
Astra est devant à effort égal sur cet indice. Le rapprochement qui m’intéresse est ailleurs : Astra Medium rejoint le score arrondi de Sol Max, à 57, avec 3,7 minutes contre 7,9. Le score arrondi ne prouve pas qu’ils réussissent les mêmes exercices, et ce tableau ne permet pas de dire lequel coûte moins cher sur ce couple de réglages. Il montre pourquoi « Sol avec plus d’effort » n’est pas forcément la seule option à essayer.
Au réglage Max, Artificial Analysis relève un coût moyen pondéré par tâche de 4,00 $ pour Astra et 1,01 $ pour Sol sur cette suite. Il s’agit de coûts mesurés dans ce protocole, pas du prix de votre prochaine demande. Les deux modèles améliorent leur score général face à leurs prédécesseurs publics, GPT-6 Astra et GPT-6.1 Sol. Il n’y a pas eu d’Astra 6.1 public ; les numéros ne désignent pas une gamme où chaque variante sort à chaque version.
Pour voir ce que change le saut de génération, j’ai repris les résultats et les prix d’Astra 6.2 face à Astra 6.
Quand monter l’effort plutôt que changer de modèle ?
Les deux modèles proposent Low, Medium, High, Extra High et Max, sans none en API. Light est le libellé de Low dans Work ; en API, Extra High s’écrit xhigh. Le niveau d’effort ne change pas le tarif unitaire. Il peut changer le temps d’attente et le nombre de tokens de raisonnement facturés.
Si Sol fait déjà le bon diagnostic mais s’arrête avant de vérifier une hypothèse, j’essaierais d’abord High ou xhigh sur les mêmes pièces. S’il rate des contraintes pourtant écrites noir sur blanc, je comparerais aussi Astra à effort moyen ou élevé. Monter directement en Max ne répare pas un brief incomplet, et rien n’oblige à payer le réglage le plus cher à chaque étape d’un même travail.
Il faut surtout garder un exercice proche de votre usage. Dans la série de tests Codex séparée, à effort Max, Astra 6.2 reste proche d’Astra 6 et Sol 6.2 recule de trois points face à Sol 6.1. Dans mon essai d’audit SEO avec Sol 6.1, la mesure des oublis et des faux positifs m’a été plus utile que la longueur du compte rendu. C’est un bon contrôle à conserver en changeant de modèle.
La fiche de Sol 6.2 face à Sol 6.1 revient sur ce recul dans Codex et sur ce qu’il vaut la peine de retester avant de remplacer Sol 6.1.
Même volume de tokens : combien coûte l’écart ?
Les fiches API d’Astra 6.2 et de Sol 6.2 donnent ces prix en dollars par million de tokens, en vitesse Standard, jusqu’à 272 000 tokens d’entrée.
| Poste facturé | Astra 6.2 | Sol 6.2 |
|---|---|---|
| Entrée non cachée | 8 $ | 2 $ |
| Lecture du cache | 0,40 $ | 0,10 $ |
| Écriture du cache, 30 minutes | 10 $ | 2,50 $ |
| Sortie facturée | 40 $ | 10 $ |
À ces tarifs, Astra coûte quatre fois plus cher par token. Au-delà de 272 000 tokens d’entrée, les prix d’entrée et de cache doublent et la sortie coûte 1,5 fois le tarif court, sur toute la requête. Ce seuil déclenche un autre prix ; ce n’est pas la quantité maximale que le modèle peut lire.
Ce que cela donne sur une demande
Prenons deux volumes, sans cache, au tarif Standard. La sortie facturée comprend le raisonnement, même si vous ne voyez pas ces tokens dans la réponse.
| Entrée et sortie facturée | Astra 6.2 | Sol 6.2 |
|---|---|---|
| 40 000 + 5 000 tokens | 0,52 $ | 0,13 $ |
| 300 000 + 10 000 tokens | 5,40 $ | 1,35 $ |
Ce sont des calculs hors outils, taxes et reprises. Si vous devez lancer plusieurs passes, comparez le coût du travail terminé, pas seulement celui de la première réponse. Joindre des fichiers inutiles finit aussi par coûter cher, quel que soit le modèle.
Dans Codex, Sol démarre avec plus de contexte qu’Astra
C’est le détail que je vérifierais avant de changer de modèle en plein dossier. Le catalogue Codex d’OpenAI indique 500 000 tokens par défaut pour Sol 6.2, comme Sol 6.1, et 272 000 pour Astra 6.2. Les deux peuvent aller jusqu’à un million dans Codex avec le réglage model_context_window. Ce réglage n’est pas actif par défaut du seul fait que le modèle le permet.
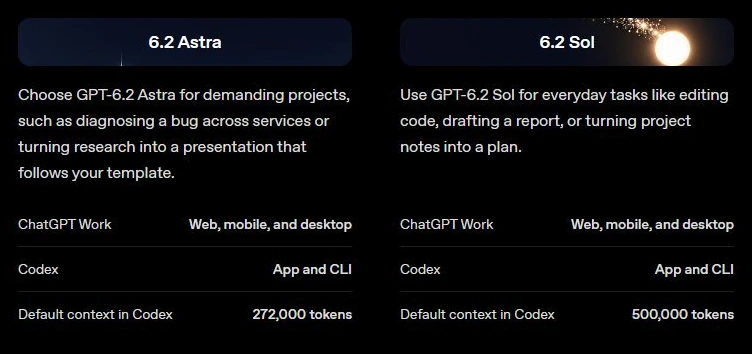
Dans l’API, OpenAI donne la même fenêtre aux deux modèles : 1 050 000 tokens, avec un plafond de 922 000 en entrée et de 128 000 en sortie. Ni ce maximum, ni le contexte affiché par le client, ni le seuil de facturation à 272 000 ne disent la même chose. Pour une analyse sur des fichiers longs, je garderais d’abord les extraits indispensables, les références et les décisions déjà prises. Une grande fenêtre n’empêche pas le modèle de négliger un détail.
Ultrafast sur Pro 200 : un avantage pour Sol dans Codex
OpenAI lance Astra 6.2 et Sol 6.2 dans ChatGPT Work, Codex et l’API, pas dans le Chat classique. Les deux modèles sont déployés dans Work et Codex sur Plus, Pro, Business, Enterprise et Edu, selon les accès au compte. Cela ne donne pas droit à la même vitesse : le centre d’aide OpenAI distingue les offres.
- Pro 200 : Ultrafast avec GPT-6.2 Sol. Astra 6.2 n’est pas disponible à cette vitesse sur ce forfait.
- Pro 500 : Ultrafast avec Astra et Sol 6.2. Les espaces Enterprise et Edu éligibles doivent disposer des droits correspondants.
- API : Ultrafast est proposé pour les deux modèles. Les tarifs de l’API et les conditions d’usage de l’abonnement restent séparés.
Chez les deux modèles, Ultrafast consomme six fois l’usage inclus du mode Standard. Pour les crédits éligibles et l’API, le barème prévoit trois fois le Standard jusqu’au 28 février 2027, puis six fois à partir du 1er mars, heure du Pacifique. Les noms Pro 200 et Pro 500 reprennent les tarifs mensuels américains, pas le montant final payé en France.
OpenAI annonce une génération jusqu’à 4,5 fois plus rapide en Ultrafast sur les deux modèles. Si la tâche passe surtout son temps à explorer des pages, lire des fichiers ou attendre des tests, je n’en déduirais pas un gain de 4,5 sur tout le délai. Pour vérifier si votre usage justifie un changement d’offre, voir mon point sur les forfaits Pro et leurs limites.
Quel réglage je choisirais sur trois tâches concrètes
- Comparer deux exports Search Console : Sol Medium pour relever les pages ou requêtes qui bougent. Je contrôlerais quelques lignes avant de lui demander d’expliquer la baisse.
- Livrer une présentation avec une charte stricte : Astra High si le modèle doit respecter la trame, retrouver les chiffres justes dans plusieurs documents et signaler les valeurs manquantes.
- Expliquer une chute après migration : Sol High pour dresser la liste des vérifications, puis Astra xhigh si les réponses HTTP, les logs et les données de recherche semblent se contredire. Je demanderais la preuve de chaque hypothèse, pas un avis plus affirmatif.
Questions fréquentes sur GPT-6.2
Quand GPT-6.2 est-il sorti ?
OpenAI a lancé GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026 dans ChatGPT Work, Codex et l’API. Aucun modèle Terra 6.2 ni Luna 6.2 n’a été annoncé dans ce lancement.
GPT-6.2 est-il disponible dans le Chat classique ?
Non, le lancement du 17 novembre n’ajoute ni Astra 6.2 ni Sol 6.2 au Chat classique. Dans ChatGPT, ouvrez Work et consultez le sélecteur de modèles de votre compte. Les deux modèles sont aussi proposés dans Codex et l’API.
Astra 6.2 Medium est-il aussi bon que Sol 6.2 Max ?
Ils affichent le même score arrondi de 57 sur l’Intelligence Index d’Artificial Analysis. Ce résultat ne signifie pas qu’ils réussissent les mêmes exercices ni qu’ils ont le même coût sur votre tâche.
Combien coûtent Astra et Sol 6.2 dans l’API ?
En Standard, jusqu’à 272 000 tokens d’entrée, Astra coûte 8 $ par million de tokens d’entrée, 0,40 $ en lecture du cache et 40 $ en sortie. Sol coûte respectivement 2 $, 0,10 $ et 10 $. Le contexte long, l’écriture du cache et la vitesse de service peuvent changer la facture.
Quel modèle a le plus de contexte par défaut dans Codex ?
Sol 6.2 démarre à 500 000 tokens, contre 272 000 pour Astra 6.2 selon la documentation Codex. Les deux montent jusqu’à un million de tokens dans le client avec une configuration adaptée. La fenêtre maximale de l’API, 1 050 000 tokens, est une autre mesure.
Ultrafast est-il inclus sur ChatGPT Pro 200 ?
Pro 200 donne accès à Ultrafast avec GPT-6.2 Sol, pas avec Astra 6.2. Pro 500 permet de l’utiliser avec les deux modèles. Ultrafast consomme plus d’usage que Standard même lorsqu’il est disponible dans le forfait.