
À peine le temps de prendre ses habitudes avec Sol 6, et OpenAI sort déjà GPT-6.1 Sol. Sept jours entre les deux versions. Je comprends qu’on puisse hésiter : faut-il changer ses réglages, rester sur Astra, ou attendre de voir autre chose qu’une annonce prometteuse ?
Cette fois, il y a des résultats intéressants à regarder. Ils suggèrent que Sol 6.1 peut se rapprocher d’Astra sur certains travaux, avec un coût nettement inférieur. Mais ils montrent aussi pourquoi « plus puissant », « moins cher » et « plus rapide » ne veulent pas dire la même chose. Je préfère comparer le travail terminé plutôt que le numéro du modèle.
GPT-6.1 Sol : une nouvelle version sortie le 29 septembre 2026
Le journal des sorties OpenAI date Sol 6.1 du 29 septembre, après Sol 6 et Luna le 22 septembre. Astra était arrivé le 3 septembre. Il s’agit donc d’une évolution de Sol, pas d’une nouvelle génération commune à tous les modèles. Dans l’API et les configurations qui demandent un identifiant, recherchez gpt-6.1-sol.
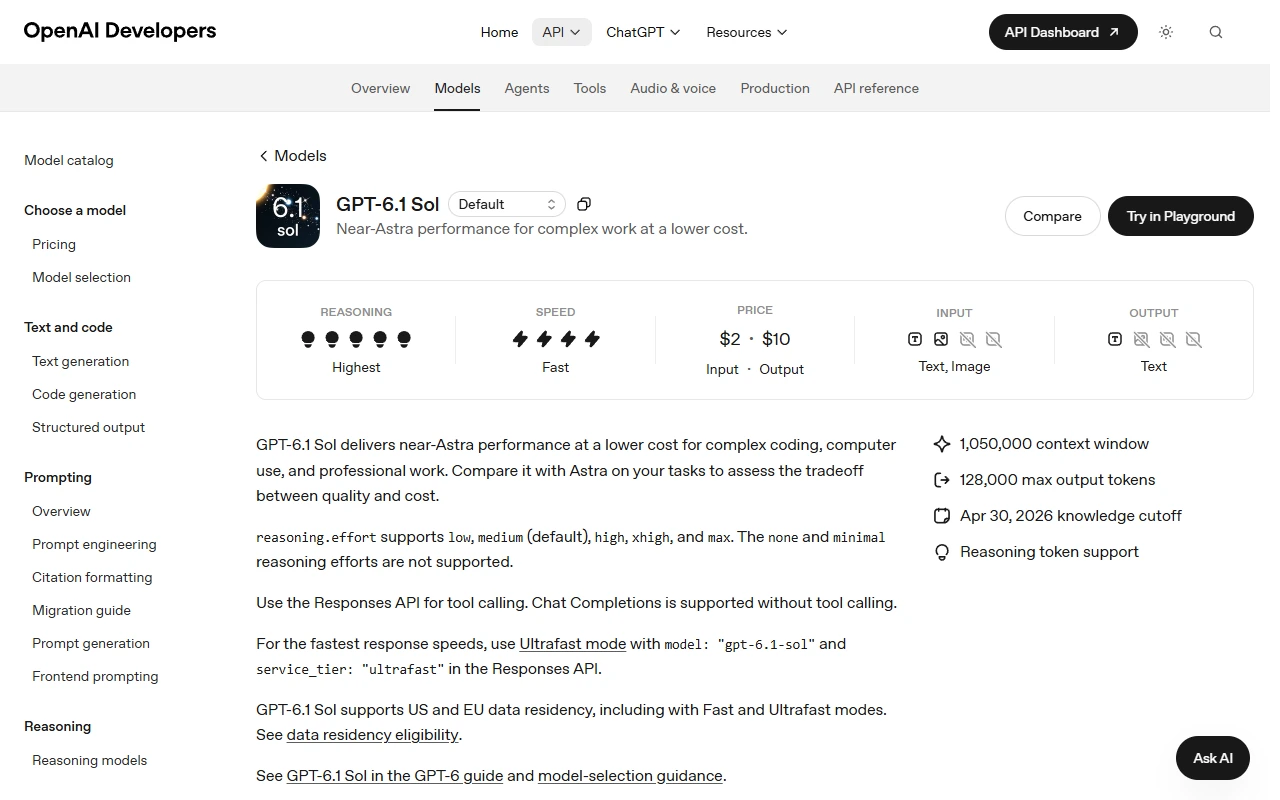
OpenAI le positionne pour le code complexe, l’utilisation de l’ordinateur et le travail professionnel, avec des performances proches d’Astra à moindre coût. Le mot important reste proches. Je ne remplacerais pas Astra sur un dossier difficile uniquement parce qu’une nouvelle version de Sol vient d’arriver.
Pour retrouver les différences générales entre les trois familles d’usage, mon guide GPT-6 Luna, Sol et Astra reste le point de départ. Ici, la question est plus précise : que gagne-t-on en passant à Sol 6.1, et quels détails peuvent encore changer le choix ?
Le changement de prix se situe surtout dans le cache
Les prix Standard d’entrée et de sortie sont les mêmes que ceux de Sol 6. La lecture du cache passe en revanche de 0,20 $ à 0,10 $ par million de tokens. Pour une application qui reprend souvent les mêmes instructions ou documents et obtient de vrais cache hits, c’est une différence à examiner. Pour une seule demande courte, sans réutilisation, ce gain ne joue pas.
La nouveauté la plus intéressante serait donc d’obtenir un résultat plus fiable au même tarif de base. C’est précisément ce que les évaluations permettent de mettre à l’épreuve, sans transformer la promesse de l’éditeur en verdict automatique.
Sol 6.1 contre Sol 6 et Astra : les résultats publiés
Artificial Analysis : proche d’Astra, avec une surprise à xhigh
Dans son évaluation du 29 septembre, Artificial Analysis place Sol 6.1 à Max environ un point sous Astra sur son Intelligence Index, et quatre points au-dessus de Sol 6. Son coût moyen par tâche passe de 1,05 $ pour Sol 6 à 0,72 $ pour Sol 6.1, contre 3,26 $ pour Astra.
Sur l’indice Coding Agent, Sol 6.1 à xhigh dépasse son propre réglage Max d’environ trois points et Astra d’environ un point. Le réglage maximal ne gagne donc pas automatiquement. Ces indices ont des protocoles distincts : un score de code n’est pas une note générale sur toute rédaction ou toute analyse SEO.
Je vois une raison d’essayer xhigh avant de mettre Max partout. Pas une raison de conclure qu’Astra est devenu inutile : le choix dépend encore du travail demandé et des erreurs observées.
J’ai aussi comparé High, xhigh et Max sur un même dossier SEO, avec les réponses, leurs oublis, le temps d’attente et le coût de chaque essai. Cela donne un repère concret pour choisir le réglage sans assimiler davantage de réflexion à une meilleure correction garantie.
Bug Hunt Bench : des corrections, pas seulement une liste de problèmes
Le Bug Hunt Bench de Paweł Huryn fait corriger 105 bugs introduits dans deux projets, avec jugement à l’aveugle. Voici les moyennes de trois essais par modèle à Max, mises à jour le 30 septembre et consultées le 1er octobre :
| Modèle et agent | Bugs corrigés / 105 | Durée moyenne | Coût estimé aux tarifs tokens |
|---|---|---|---|
| GPT-6.1 Sol / Codex CLI | 44,3 | 139 min | 5,88 $ |
| GPT-6 Sol / Codex CLI | 29,3 | 63 min | 9,33 $ |
| GPT-6 Astra / Codex CLI | 45,0 | 90 min | 33,03 $ |
| Claude Sonnet 5.5 / Claude Code | 51,3 | 287 min | 154,03 $ |
Les décimales viennent des moyennes. Agents différents selon l’éditeur, projets de test non publics et coûts tokens estimés : ces chiffres ne sont ni une facture d’abonnement, ni une garantie. 44,3 contre 45 ne départage pas solidement Sol 6.1 et Astra. Ici, Sol 6.1 prend davantage de temps tout en coûtant moins.
Pourquoi je ne choisirais pas avec un seul score
Une correction technique peut être bon marché et pourtant immobiliser une session longtemps. Une autre peut sortir vite, mais demander une relecture laborieuse. Pour un freelance, les deux situations ont un coût. Je noterais donc le temps jusqu’au résultat validé, pas seulement la durée de génération ou le nombre de tokens par seconde.
Autre piège : comparer deux agents qui n’ont pas les mêmes outils, permissions ou fichiers. Le modèle compte, mais le logiciel autour de lui compte aussi. Un test où un agent peut exécuter les vérifications et l’autre non ne permet pas d’attribuer toute la différence au modèle.
Enfin, ces évaluations ne démontrent pas que Sol 6.1 écrit mieux en français, trouve les meilleures sources ou comprend parfaitement une chute d’impressions. Ce sont d’autres tâches, avec d’autres critères de réussite.
Niveaux de réflexion : faut-il choisir xhigh ou Max ?
Le niveau de réflexion ne sert pas simplement à produire une réponse plus longue. Il change la quantité de travail que le modèle peut consacrer à la demande. Une conclusion de trois phrases peut demander une analyse difficile ; un texte de trois pages peut être assez mécanique.
Dans l’API, Sol 6.1 accepte low, medium, high, xhigh et max, avec medium par défaut. Contrairement à Sol 6, il n’accepte ni none ni minimal.
| Réglage | Je commencerais ici pour… | Le contrôle qui compte |
|---|---|---|
| Low / Light | Une correction bien délimitée, une transformation simple. | Vérifier que les contraintes sont toutes respectées. |
| Medium | Un travail courant avec quelques étapes. | Contrôler la conclusion, pas seulement la présentation. |
| High | Un dossier avec plusieurs sources ou cas particuliers. | Retrouver les preuves et les exceptions. |
| xhigh / Extra High | Un problème technique difficile ou une relecture exigeante. | Comparer les oublis et le temps de reprise avec High. |
| Max | Une tâche particulièrement difficile, sans priorité à la vitesse. | Vérifier qu’il fait réellement mieux que xhigh sur ce travail. |
Ce tableau décrit mes points de départ, pas des seuils officiels de difficulté. Si Medium réussit une tâche répétée, je n’augmenterais pas la puissance par habitude. Si High manque régulièrement une contrainte importante, je comparerais xhigh sur la même tâche, puis un autre modèle si nécessaire.
Ultra et Ultrafast : deux autres notions
xhigh règle le raisonnement ; Ultra utilise des sous-agents ; Ultrafast concerne la vitesse. Ultra n’est donc pas une valeur à envoyer dans reasoning.effort. Depuis le 8 octobre 2026, Ultrafast est disponible pour Sol 6.1 dans Responses avec service_tier: "ultrafast". Dans Work et Codex, son accès concerne l’offre Pro à 500 dollars et les offres Enterprise ou Edu éligibles, selon les réglages du compte.
Un travail divisible peut bénéficier de plusieurs agents. Pour une petite correction dans un seul fichier, cette organisation peut aussi ajouter de la coordination inutile. Je garderais un responsable du résultat final et des tests, quel que soit le nombre d’agents mobilisés.
Sol 6.1 passe à 500 000 tokens par défaut dans Codex et Work
Dans son annonce publiée dans la nuit du 11 au 12 octobre 2026, Tibo Sottiaux, de l’équipe OpenAI, indique que le contexte par défaut de GPT-6.1 Sol dans Codex et ChatGPT Work passe de 272 000 à 500 000 tokens. Le but annoncé est de réduire les compactages sur les tâches longues. Ce changement ne concerne pas automatiquement Sol 6, Luna ou Astra, ni une conversation ChatGPT classique.
Pour un projet qui s’étale sur plusieurs échanges, c’est une évolution plus utile qu’un simple changement de nom : davantage de fichiers, de résultats d’outils et de nuances peuvent rester dans le contexte avant qu’il soit résumé. Mais le compactage existe toujours, et un contexte plus grand ne garantit ni une meilleure réponse ni une mémoire permanente.
| Repère | Valeur | Ce que cela signifie |
|---|---|---|
| Défaut annoncé pour Sol 6.1 dans Codex / Work | 500 000 tokens | Le budget nominal choisi par défaut, pas le maximum du modèle. |
| Part utilisable dans le catalogue Codex contrôlé | 475 000 tokens | 500 000 × 95 %, après une marge de sécurité de 5 %. |
| Plafond indiqué par ce catalogue Codex | 872 000 tokens | Une limite du client consulté, distincte de la fiche API ; 95 % donnent 828 400 tokens par calcul. |
| Fenêtre maximale documentée dans l’API | 1 050 000 tokens | La capacité totale publiée pour le modèle, avec une sortie limitée à 128 000 tokens. |
475 000 n’est donc pas un arrondi de 500 000. Le catalogue de modèles utilisé par le client Codex, contrôlé le 13 octobre, indique context_window: 500000, max_context_window: 872000 et effective_context_window_percent: 95. Le chiffre affiché et le budget nominal peuvent différer. Ces valeurs décrivent le client consulté, pas une promesse de limite identique pour tous les comptes et toutes les versions.
La configuration de Codex distingue model_context_window, le budget de contexte, de model_auto_compact_token_limit, le seuil de résumé automatique. Modifier un nombre ne supprime pas le plafond du client ni celui du modèle. Je ne conseillerais donc pas de saisir un million par réflexe : un réglage plus élevé peut être plafonné, et davantage d’historique peut aussi consommer plus de ressources.
Dans une précision publiée juste après, Tibo Sottiaux indique qu’il n’y a pas de majoration spécifique au long contexte pour Sol 6.1 lorsque l’usage est prélevé sur l’abonnement. Cela ne rend pas les échanges gratuits ou illimités. La tarification API reste séparée, avec son seuil de 272 000 tokens d’entrée détaillé ci-dessous.
Prix de GPT-6.1 Sol : combien coûte une demande ?
Les tarifs API Standard ci-dessous sont exprimés en dollars par million de tokens, pour une requête contenant au plus 272 000 tokens d’entrée. Le cache désigne ici la lecture d’une entrée réutilisée, pas un abonnement.
| Modèle | Entrée | Lecture du cache | Sortie |
|---|---|---|---|
| GPT-6.1 Sol | 2 $ | 0,10 $ | 10 $ |
| GPT-6 Sol | 2 $ | 0,20 $ | 10 $ |
| GPT-6 Astra | 10 $ | 1 $ | 50 $ |
| GPT-6 Luna | 0,10 $ | 0,01 $ | 0,50 $ |
La lecture du cache de Sol 6.1 coûte 95 % de moins que son entrée non mise en cache. Ce n’est pas une réduction de 95 % de toute la facture. L’écriture du cache est distinguée à 2,50 $ par million de tokens. Il faut donc regarder ce qui a réellement été lu, écrit et généré.
Un calcul simple, sans le confondre avec un benchmark
Pour 20 000 tokens d’entrée non mis en cache et 4 000 tokens de sortie facturés, sans outil payant, le calcul donne :
- Sol 6.1 : 0,08 $, autant que Sol 6 à ces volumes.
- Astra : 0,40 $.
- Luna : 0,004 $, soit 0,4 centime de dollar.
C’est une comparaison à volumes identiques, pas une mesure du coût d’une tâche réussie. Une tentative moins chère suivie de quatre reprises peut finalement coûter davantage. Je comparerais aussi la consommation totale, les outils, les erreurs et le temps de contrôle.
Les tokens de raisonnement sont facturés comme de la sortie. Ils ne sont pas tous visibles dans le texte final. Les 4 000 tokens de cet exemple doivent les inclure ; compter seulement les mots affichés sous-estime la consommation.
Les longs fichiers et les modes de vitesse changent le calcul
Au-delà de 272 000 tokens d’entrée dans l’API, les taux d’entrée et de cache doublent, et le taux de sortie est multiplié par 1,5 pour toute la requête. Ce n’est pas un supplément limité à la partie dépassée. Les modes Batch et Flex affichent la moitié des tarifs Standard ; Fast coûte le double des taux applicables et Ultrafast six fois ces taux. Un traitement régional ajoute 10 % là où il est disponible.
Je découperais un gros dossier pour une raison de compréhension avant de le faire pour une raison de prix : que doit-on vraiment rapprocher dans une même demande ? Accumuler tous les fichiers disponibles n’aide pas forcément à produire une meilleure conclusion.
Où utiliser Sol 6.1 : Work, Codex et API, pas Chat classique
La documentation des modèles ChatGPT précise que Sol 6.1 est proposé dans Work et Codex, pas dans Chat. Au lancement, Plus, Pro, Business, Enterprise et Edu sont concernés ; Free et Go ne le sont pas. Sur Enterprise et Edu, l’administrateur doit l’activer.
Si vous cherchez « ChatGPT 6.1 » dans une conversation classique et ne voyez rien, ce n’est donc pas forcément un bug. Le produit, la version du client et les autorisations peuvent expliquer l’absence du modèle. Vérifiez le sélecteur ou la configuration réellement utilisés.
La facturation de l’API est séparée de l’abonnement. Et Work et Codex partagent leur consommation. Dans leur barème d’usage, Fast consomme 2,5 fois l’usage Standard inclus, mais deux fois le taux Standard des crédits achetés ou de la facturation Enterprise à l’usage.
Pour Sol 6.1 Ultrafast, le même barème distingue 8 fois l’usage inclus et 6 fois le taux des crédits achetés ou de la facturation Enterprise à l’usage. Ce sont des multiplicateurs de consommation, pas la promesse d’une tâche terminée huit fois plus vite.
C’est pourquoi je ne convertirais pas les 5,88 $ d’un benchmark en un pourcentage précis de votre forfait. Le protocole, le type de facturation et les volumes doivent être les mêmes pour que cette conversion ait un sens. Mon dossier ChatGPT Pro Max : prix et limites Work/Codex aide à séparer les conditions d’abonnement des performances du modèle.
Pour le SEO, le code et les contenus : ce que je lui confierais
Du code : une correction connue avant une refonte risquée
Je commencerais par un problème dont je sais déjà vérifier la solution. Par exemple, un formulaire qui accepte une valeur invalide, une redirection incorrecte ou un composant qui déborde sur mobile. Même demande et même environnement pour Sol 6.1 et Astra, puis contrôle du résultat complet.
« Ça compile » n’est pas suffisant. La page doit rester utilisable, conserver les données, respecter les autorisations et ne pas casser une autre route. Si Sol 6.1 réussit ce travail sans intervention lourde, il mérite ensuite un essai plus ambitieux. Je ne lui confierais pas directement une migration entière pour découvrir ses limites en production.
Des exports SEO : les chiffres avant l’explication
Pour trier un export très régulier, Luna peut rester plus adapté économiquement. Sol 6.1 devient intéressant lorsqu’il faut rapprocher plusieurs périodes, distinguer une anomalie d’une tendance et confronter plusieurs explications. Encore faut-il demander les lignes et calculs qui soutiennent le diagnostic.
Je vérifierais notamment les filtres, les périodes incomplètes et les changements de périmètre. Une hausse d’impressions accompagnée d’une baisse de position moyenne peut avoir plusieurs lectures. La qualité de l’analyse dépend aussi des données disponibles, pas seulement du réglage Max.
De la rédaction sourcée : garder la personne derrière le texte
Sol 6.1 peut être un candidat pour rapprocher des sources, reprendre un passage ou construire une comparaison. Je lui demanderais de conserver les faits, les nuances et la voix, pas de fabriquer un témoignage. « J’ai testé » n’a sa place que lorsque le test a réellement eu lieu.
Sa date de connaissances annoncée reste le 30 avril 2026. Pour une annonce récente, un tarif ou une règle Google, il faut consulter des pages actuelles. Mon comparatif Deep Research, Perplexity et assistants IA pour vérifier ses sources explique pourquoi une réponse sourcée doit encore être contrôlée.
Un meilleur résultat peut justifier Astra
Si la difficulté vient d’un dossier contradictoire, d’une consigne ambiguë ou de plusieurs systèmes qui interagissent, je garderais Astra parmi les options. Un modèle plus coûteux peut se justifier s’il réduit réellement les reprises. Mais je veux voir cette différence sur le travail concerné, pas la supposer à partir de son nom.
À l’inverse, un besoin précis et répétitif n’impose pas Sol 6.1. Dans une petite activité web, une combinaison sobre vaut souvent mieux qu’un abonnement supplémentaire choisi sous l’effet de l’annonce.
Si votre travail porte surtout sur des images, des interfaces ou de la rédaction, je regarderais aussi Terra 6.1 et ses différences avec Sol 6.1. Son tarif API est inférieur, mais je comparerais le résultat et les reprises nécessaires avant de lui confier un usage jusque-là réservé à Sol.
Voir des comparaisons de Sol 6.1 en français
DigitalNovator compare Sol 6.1 à d’autres modèles sur des réalisations visuelles, dont un thermomètre de Galilée et des interfaces web. On peut examiner les détails, les ratés et les temps affichés. La vidéo est longue, mais elle apporte davantage qu’une succession de scores pour ceux qui veulent voir des réalisations concrètes.
Je la prends comme une série d’essais commentés, pas comme un classement universel. Les coûts affichés sont des équivalents aux tarifs API ; ils ne sont pas nécessairement une facture payée ni les quotas d’un abonnement.
Pour voir les réalisations et les commentaires, retrouvez les tests de GPT-6.1 Sol par DigitalNovator.
Avant de passer de Sol 6 à Sol 6.1 : les réglages à vérifier
Une configuration enregistrée peut continuer à appeler gpt-6-sol. Je commencerais donc par vérifier le modèle effectif, puis je conserverais un exemple de travail réussi pour comparer. Le changement de nom ne remplace pas une petite non-régression.
- Le niveau de réflexion. Une requête qui utilise
noneouminimaldoit être adaptée : Sol 6.1 ne les accepte pas. - Les appels d’outils. Avec Sol 6.1, utilisez Responses. Chat Completions est pris en charge sans appels d’outils.
- La résidence des données. Sol 6.1 prend désormais en charge les États-Unis et l’Union européenne, y compris avec Fast et Ultrafast. Vérifiez aussi l’éligibilité de votre compte.
- Le budget réel. Incluez raisonnement, reprises et outils, pas seulement la sortie lisible.
- Les permissions et contrôles. Changer de modèle ne lui donne pas de nouvelles autorisations et ne dispense pas de vérifier le résultat.
La fiche API de Sol 6.1 annonce 1 050 000 tokens de contexte et 128 000 tokens de sortie maximum. Un grand contexte n’est pas une mémoire persistante : les fichiers, l’historique et leur réutilisation dépendent aussi du client. Je ne considérerais pas un document envoyé une fois comme mémorisé pour toujours.
L’accès ChatGPT proposé par RankerFox : ce qu’il faut vérifier
Si vous utilisez déjà RankerFox, je regarderais cet accès avant de payer un abonnement supplémentaire. Le catalogue RankerFox annonce ChatGPT Pro, aux côtés d’outils SEO et IA. Il ne précise toutefois pas la version du modèle ni toutes les interfaces fournies.
Pour Sol 6.1, vérifiez sa présence dans le sélecteur de l’accès fourni. Le nom « ChatGPT Pro » ne suffit pas à confirmer cette version, notamment parce qu’elle est proposée dans Work et Codex plutôt que dans Chat. Je contrôlerais également les sessions, les fichiers et les conditions dont mon travail dépend.
Un accès mutualisé n’équivaut pas à un abonnement personnel ou à des crédits API. Mon avis sur RankerFox détaille ce compromis. Vous pouvez aussi consulter l’offre actuelle de RankerFox avant de décider.
Avis ToolsBoxSEO en bref
Sol 6.1 mérite un essai sérieux comme modèle de travail courant, notamment si Astra vous coûte cher. Les résultats publiés montrent un progrès face à l’ancien Sol. Je commencerais par une tâche connue à High ou xhigh, puis je comparerais le résultat, les oublis et le temps de reprise.
Je garderais Astra pour les dossiers qui lui donnent un avantage observable, et Luna pour les traitements bien définis. Ce qui m’intéresse n’est pas de gagner un concours de noms de modèles : c’est de terminer le travail sans laisser des erreurs discrètes derrière.
Questions fréquentes sur GPT-6.1 Sol
Quand GPT-6.1 Sol est-il sorti ?
GPT-6.1 Sol est sorti le 29 septembre 2026, sept jours après Sol 6. Il s’agit d’une nouvelle version de Sol, pas d’un passage simultané d’Astra et Luna à la version 6.1.
GPT-6.1 Sol est-il meilleur qu’Astra ?
Certains tests publiés le placent près d’Astra, voire au-dessus sur une évaluation de code à xhigh. Cela ne démontre pas une supériorité sur toutes les tâches. Comparez les résultats avec les mêmes fichiers, outils et contrôles.
Quel est le prix API de GPT-6.1 Sol ?
Au 13 octobre 2026, le tarif API Standard jusqu’à 272 000 tokens d’entrée est de 2 dollars par million de tokens d’entrée, 0,10 dollar en lecture du cache et 10 dollars en sortie. L’écriture du cache est distinguée à 2,50 dollars. Raisonnement, outils, vitesse et long contexte peuvent changer le total.
Faut-il utiliser xhigh ou Max ?
Max ne gagne pas automatiquement toutes les évaluations. Un test de code publié par Artificial Analysis donne un meilleur résultat à xhigh. Essayez un travail représentatif et retenez le réglage qui améliore réellement le résultat, pas seulement la durée de réflexion.
Pourquoi Sol 6.1 n’apparaît-il pas dans ChatGPT classique ?
OpenAI le propose dans Work et Codex, pas dans Chat. Plus, Pro, Business, Enterprise et Edu sont concernés au lancement ; Free et Go ne le sont pas. L’accès dépend aussi du client et des réglages de l’espace de travail.
Peut-on garder reasoning.effort à none ?
Non. Sol 6.1 n’accepte ni none ni minimal. Les valeurs compatibles sont low, medium, high, xhigh et max, avec medium par défaut. Une ancienne configuration Sol 6 doit donc vérifier ce paramètre.
Ultra et Ultrafast sont-ils disponibles avec Sol 6.1 ?
Ultra utilise des sous-agents et dépend du client et des réglages. Ultrafast est disponible pour Sol 6.1 depuis le 8 octobre 2026 : dans l’API Responses, et dans Work/Codex pour l’offre Pro à 500 dollars et les offres Enterprise ou Edu éligibles. Il ne correspond pas à un niveau reasoning.effort.
Pourquoi Codex affiche-t-il 475 000 tokens au lieu de 500 000 ?
Le catalogue Codex contrôlé le 13 octobre donne à Sol 6.1 un budget nominal de 500 000 tokens et une part utilisable de 95 %, soit 475 000 tokens. C’est une marge de sécurité, pas un arrondi. La fenêtre API de 1 050 000 tokens ne garantit pas le même affichage dans chaque client.
RankerFox donne-t-il accès à Sol 6.1 ?
Le catalogue public de RankerFox annonce ChatGPT Pro, sans préciser la version. Vérifiez que GPT-6.1 Sol est présent dans le sélecteur de l’accès fourni et contrôlez les conditions d’usage. Un accès mutualisé ne donne pas automatiquement les mêmes droits qu’un abonnement personnel.