
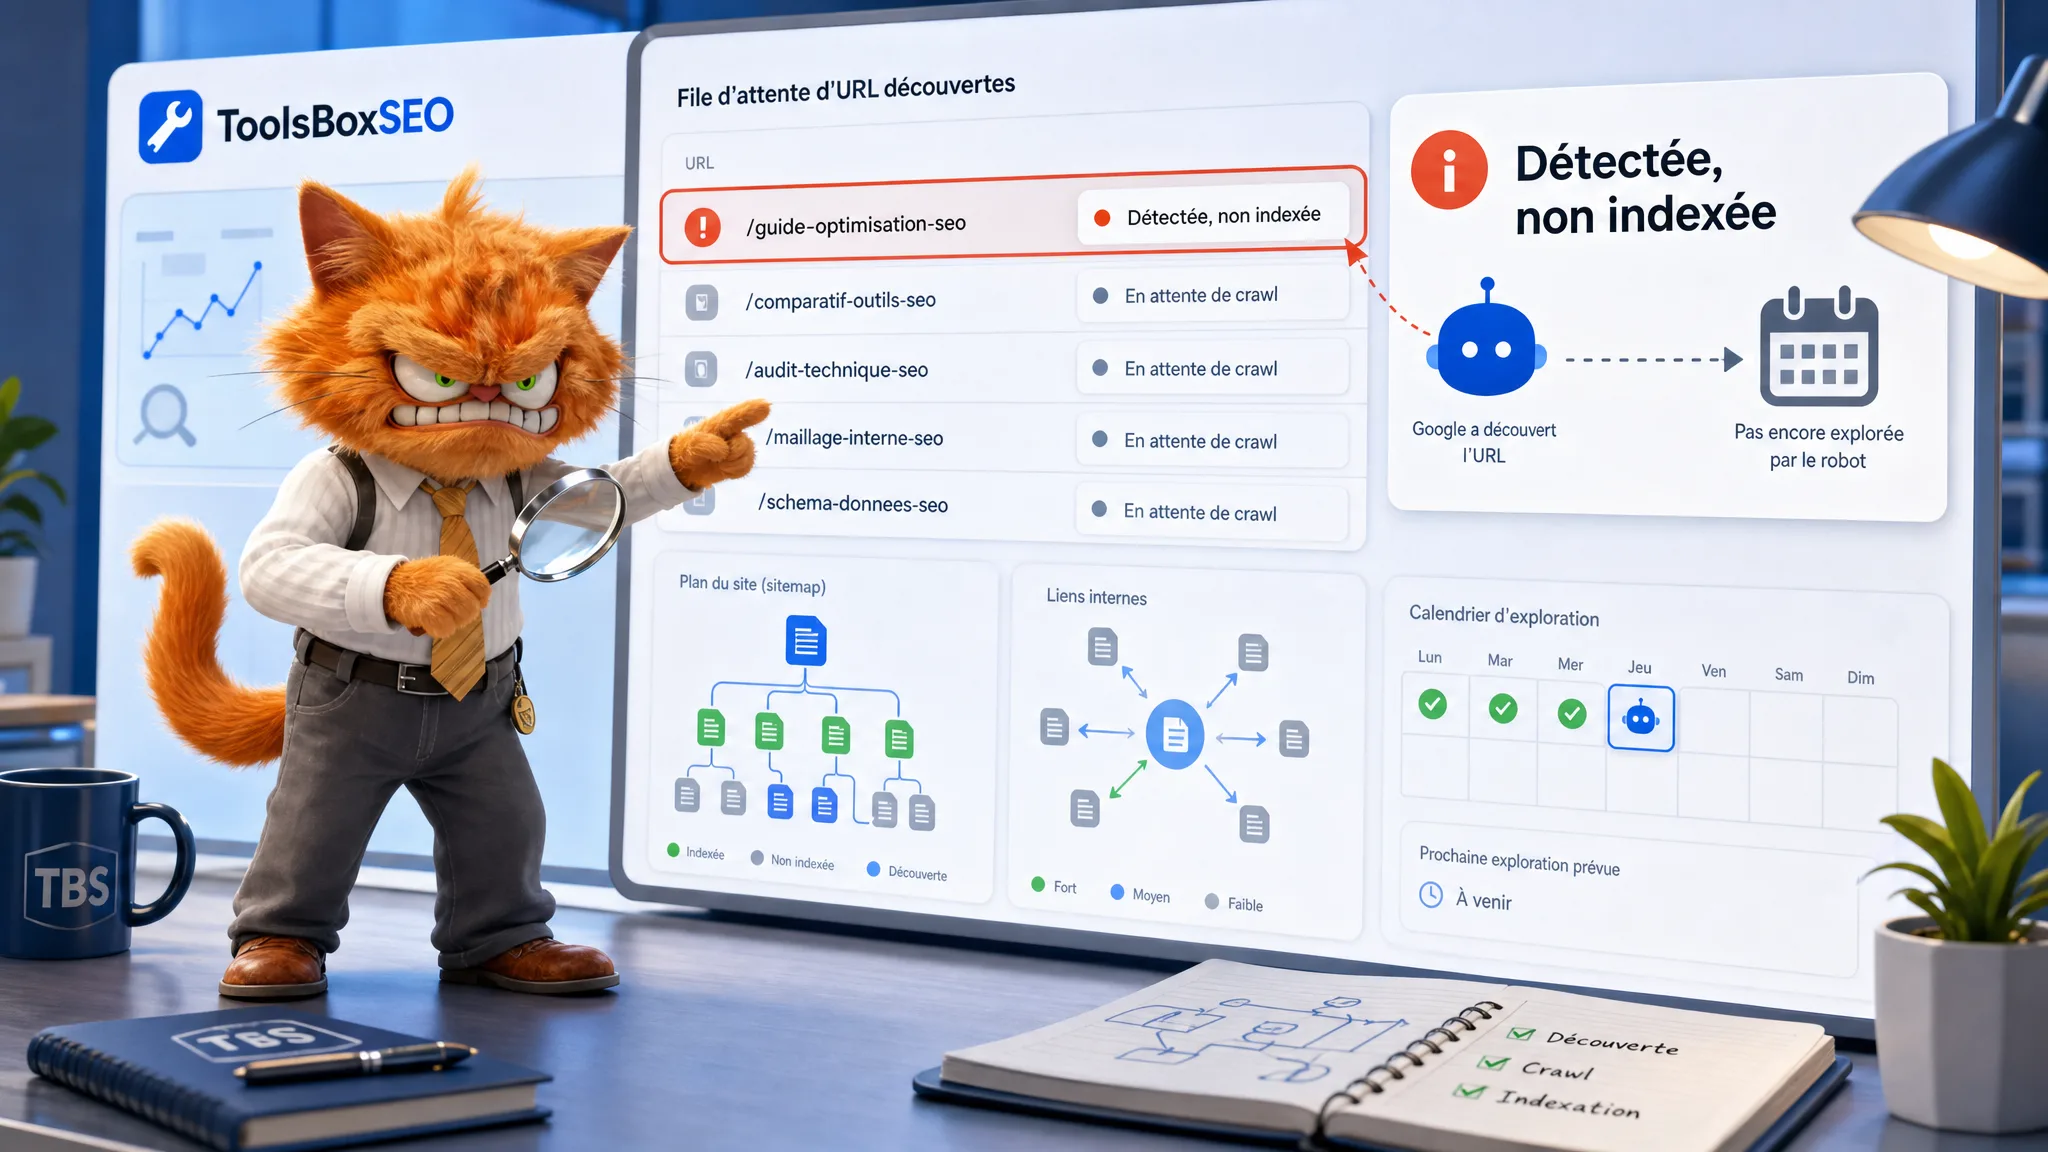
Le statut “Détectée, actuellement non indexée” est frustrant parce qu’il donne une impression de demi-victoire. Google connaît l’URL. Elle n’est pas perdue dans un coin du site. Elle peut même être présente dans le sitemap. Pourtant, rien ne se passe : pas de crawl visible, pas de dernière exploration, pas d’indexation.
La tentation est de cliquer sur “Demander une indexation” pour toutes les URL concernées, ou de réécrire les textes au hasard. Mauvais réflexe. Tant que Google n’a pas exploré la page, le problème n’est pas encore la qualité fine du contenu. Le premier sujet, c’est plutôt : pourquoi cette URL n’a-t-elle pas assez de priorité pour être explorée maintenant ?
Mon avis : ce statut est moins un message d’erreur qu’un signal de file d’attente. Sur une URL importante, il mérite un diagnostic sérieux. Sur une URL faible, filtrée, dupliquée ou profonde, il peut simplement révéler que Google n’a pas envie de dépenser du crawl dessus. La nuance change tout.
Ce que ce statut veut dire
Dans le rapport d’indexation des pages, Google distingue les URL indexées des URL connues mais non indexées. Pour le statut “Détectée, actuellement non indexée”, la logique est précise : Google a repéré l’URL, mais ne l’a pas encore explorée.
La conséquence est importante : la colonne “Dernière exploration” reste vide, parce que Googlebot n’est pas encore venu récupérer la page. On n’est pas dans une situation où Google a lu le contenu puis l’a rejeté. On est avant cette étape.
C’est pour cela que les corrections doivent commencer par l’accès, la découverte et la priorité de crawl. Si une URL est orpheline, trop profonde, noyée dans un sitemap plein de pages faibles, lente à servir, ou perdue au milieu de milliers de variantes inutiles, Google peut parfaitement la connaître sans la visiter vite.
Différence avec “Explorée, actuellement non indexée”
Les deux statuts se ressemblent, mais ils ne se traitent pas dans le même ordre. L’article sur “Explorée, actuellement non indexée” concerne les pages que Google a déjà parcourues. Là, le diagnostic porte davantage sur l’utilité, le canonique, la duplication, la qualité perçue et la cohérence du contenu.
Avec “Détectée, actuellement non indexée”, Google n’a pas encore franchi cette étape. Avant de juger le texte, il faut comprendre pourquoi l’URL reste dans la file. C’est souvent un sujet de priorisation : liens internes faibles, sitemap trop large, pages profondes, serveur lent, inventaire d’URL trop bruyant, ou site récent qui n’a pas encore beaucoup de signaux.
| Statut | Ce que Google a fait | Diagnostic prioritaire | Mauvais réflexe courant |
|---|---|---|---|
| Détectée, actuellement non indexée | Google connaît l’URL, mais ne l’a pas encore explorée. | Découverte, maillage, sitemap, profondeur, logs, serveur, inventaire d’URL. | Réécrire tout le contenu sans savoir si Googlebot l’a déjà récupéré. |
| Explorée, actuellement non indexée | Google a exploré la page, mais ne l’a pas indexée. | Utilité de la page, duplications, canonique, intention, contenu, signaux internes. | Renvoyer l’URL en indexation sans corriger la raison probable du refus. |
| URL inconnue ou absente des rapports | Google ne semble pas encore connaître l’URL, ou Search Console ne la remonte pas. | Liens crawlables, sitemap, robots, route publique, statut HTTP. | Conclure avec la commande site: seule. |
Quand faut-il vraiment s’inquiéter ?
Une nouvelle URL qui reste quelques jours dans ce statut n’est pas forcément un drame. Google rappelle que l’exploration et l’indexation peuvent prendre du temps, et qu’une demande de crawl ne garantit pas une inclusion immédiate dans les résultats. Sur un site récent ou un gros lot de nouvelles pages, il faut donc garder un peu de patience.
En revanche, le signal devient plus sérieux dans trois cas. D’abord, si les URL concernées sont stratégiques : articles importants, pages catégories, pages outils, pages commerciales ou pages produits qui doivent générer du trafic. Ensuite, si le volume augmente régulièrement. Enfin, si les URL restent bloquées pendant plusieurs semaines malgré un sitemap propre, des liens internes visibles et un serveur sain.
Le vrai mauvais signe
Ce n’est pas d’avoir quelques URL “Détectées”. C’est de voir beaucoup d’URL importantes rester dans cet état alors que les pages sont accessibles, utiles, liées depuis des zones fortes du site et présentes dans un sitemap propre.
Diagnostic en 9 étapes
Le bon diagnostic commence par un échantillon. Ne partez pas de la ligne globale dans Search Console. Exportez quelques URL concernées et classez-les par type : article, catégorie, fiche produit, filtre, pagination, tag, archive, ancienne URL, page générée automatiquement.
Toutes les pages détectées ne méritent pas l’index. Les filtres, facettes, pages tags faibles ou pages de tri peuvent rester hors index sans créer de perte SEO.
Une page stratégique doit répondre en 200 stable, sans chaîne de redirection inutile, sans erreur serveur intermittente, sans blocage par pare-feu ou protection trop agressive.
Même si Google n’a pas encore exploré l’URL, vérifiez qu’elle n’est pas destinée à être bloquée, canonisée ailleurs ou retirée de l’index.
L’outil d’inspection d’URL indique notamment comment Google a découvert l’URL, si un sitemap est connu, si une page d’origine apparaît et si une exploration a déjà eu lieu.
La page est-elle liée depuis une page crawlable, avec un vrai
<a href>, un texte d’ancre clair et un chemin logique depuis une zone forte du site ?Un sitemap aide Google à découvrir les URL, mais ne garantit ni crawl ni indexation. Il doit contenir les pages importantes, pas tout le bruit du site.
Un outil de crawl montre la profondeur, les liens entrants internes, les canonicals, les statuts, les redirections et les pages orphelines côté site.
Si Googlebot n’a jamais demandé l’URL, le sujet reste la priorité de crawl. S’il l’a demandée malgré le statut, vérifiez la date, le code réponse, le user-agent et les erreurs.
Si Google découvre trop de variantes inutiles, vos pages importantes peuvent perdre en priorité. Le tri des URL faibles devient alors plus utile qu’une demande d’indexation massive.
Cette méthode rejoint le guide sur les écarts entre Google Search, sitemap, crawl local et Search Console. Une seule source ne suffit pas à comprendre ce que Google connaît, ce que le site expose et ce que Googlebot visite réellement.
Les causes fréquentes
Quand le statut touche quelques URL récentes, la cause peut être simplement le délai. Quand il touche beaucoup de pages, il faut chercher un motif plus structurel.
| Cause probable | Signal observable | Ce qu’il faut corriger | Délai réaliste |
|---|---|---|---|
| Page trop profonde | Peu de liens internes, accès en 4 ou 5 clics, absence des pages fortes. | Créer un chemin interne naturel depuis une rubrique, un article proche ou une page catégorie utile. | Quelques jours à plusieurs semaines selon le site. |
| Sitemap trop bruyant | Le sitemap contient tags faibles, filtres, anciennes URL ou pages sans valeur. | Réserver le sitemap aux URL indexables et importantes, avec des dates de mise à jour fiables. | Progressif, après revisite du sitemap. |
| Serveur lent ou instable | Erreurs 5xx, temps de réponse élevés, pics de charge, protections qui bloquent des requêtes. | Stabiliser l’hébergement, le cache, les erreurs, les ressources et les routes importantes. | Variable, mais les effets peuvent être visibles après amélioration de la disponibilité. |
| Inventaire d’URL trop large | Facettes, tris, paramètres, pages générées et variantes créent beaucoup d’URL à faible intérêt. | Consolider, bloquer proprement les zones non utiles, corriger les canonicals et réduire le bruit. | Plutôt moyen terme. |
| Liens non crawlables | Navigation en JS fragile, boutons sans href, liens injectés tard, ancres vides. | Utiliser de vrais liens HTML crawlables et des textes d’ancre descriptifs. | Souvent rapide après correction technique. |
| Site récent ou faible popularité | Peu de liens externes, peu d’historique, découverte lente des nouvelles pages. | Renforcer les pages importantes, le maillage, la régularité éditoriale et les signaux de confiance. | Plus lent, souvent par accumulation. |
Corrections selon le type d’URL
La bonne correction dépend du type de page. Pour un article stratégique, le maillage interne et la mise en avant éditoriale comptent beaucoup. Une page importante ne doit pas vivre seulement dans le sitemap : elle doit être liée depuis une page réellement crawlée et utile pour le lecteur.
Pour une page catégorie, regardez si elle possède un rôle clair. Une catégorie vide, trop proche d’une autre ou sans contenu éditorial minimal peut être découverte sans être priorisée. À l’inverse, une vraie page de rubrique avec un chemin de navigation, des articles liés et un rôle dans l’architecture du site mérite d’être mieux poussée.
Pour un site e-commerce, le sujet est souvent l’inventaire. Les filtres, tri par prix, variantes, paramètres UTM, pages de recherche interne et paginations peuvent créer une masse d’URL que Google connaît sans vouloir tout explorer. Dans ce cas, l’article sur la réduction du crawl Google complète bien le diagnostic : le but n’est pas de “forcer” Google, mais de rendre l’inventaire plus propre.
Enfin, pour une refonte ou une migration, croisez ce statut avec les logs. Une URL détectée mais jamais demandée ne raconte pas la même histoire qu’une ancienne URL qui redirige mal, qu’une page nouvelle trop profonde ou qu’un sitemap qui expose encore des routes obsolètes. Le guide sur Googlebot, logs serveur et migration SEO aide à faire cette séparation.
Quand demander l’indexation ?
L’outil d’inspection d’URL peut aider pour quelques URL importantes. Google précise cependant que l’exploration peut prendre plusieurs jours ou semaines, et qu’une demande ne garantit pas une inclusion instantanée ni même une inclusion tout court. C’est utile pour une page stratégique corrigée, pas pour vider une liste de centaines d’URL.
Avant de demander l’indexation, vérifiez trois points simples :
- la page répond bien en 200, sans blocage, sans redirection inutile et sans erreur intermittente ;
- elle est liée depuis au moins une page interne pertinente et crawlable ;
- elle mérite réellement d’être indexée, avec une intention claire et une valeur distincte.
Le bon usage de la demande d’indexation
Utilisez-la comme un signal ponctuel après correction d’une page importante. Ne l’utilisez pas comme une rustine pour compenser un sitemap sale, un maillage faible ou un site qui expose trop d’URL sans intérêt.
Comment suivre le retour de Googlebot
Le suivi doit rester sobre. Dans Search Console, surveillez l’évolution du groupe d’URL, mais ne tirez pas de conclusion sur une journée isolée. Les rapports ont du délai, les exemples ne sont pas toujours exhaustifs, et Google regroupe les URL par motifs.
Pour les pages importantes, le meilleur trio reste : Inspection d’URL, logs serveur et crawl local. L’inspection donne l’état vu par Google, les logs confirment si Googlebot a réellement demandé l’URL, et le crawl local montre comment votre propre site expose cette page.
Si le statut se transforme en “Explorée, actuellement non indexée”, ce n’est pas forcément une mauvaise nouvelle : Googlebot est enfin passé. Le diagnostic change simplement d’étape. Il faut alors lire le canonique, le contenu, les doublons, la valeur de page et le maillage, plutôt que rester bloqué sur la découverte.
Verdict ToolsBoxSEO
“Détectée, actuellement non indexée” doit être traité comme un problème de priorité, pas comme une condamnation de la page. Google connaît l’URL, mais il n’a pas encore assez de raisons, de disponibilité ou de budget pour venir la récupérer rapidement.
La meilleure réponse est rarement spectaculaire : réduire le bruit, mieux lier les pages importantes, nettoyer le sitemap, stabiliser le serveur, vérifier les logs et concentrer les efforts sur les URL qui ont vraiment un rôle SEO. C’est moins satisfaisant qu’un bouton magique, mais c’est beaucoup plus fiable.
Sur un petit site éditorial, quelques URL dans ce statut peuvent simplement demander du temps. Sur un site volumineux, e-commerce ou récemment refondu, un gros volume d’URL détectées mais jamais explorées peut révéler un vrai problème d’inventaire, de crawl budget ou de structure interne. C’est là qu’il faut agir.
FAQ
Que signifie “Détectée, actuellement non indexée” dans Search Console ?
Ce statut signifie que Google connaît l’URL, mais qu’il ne l’a pas encore explorée. La page n’a donc pas encore été récupérée par Googlebot pour être évaluée en vue d’une éventuelle indexation.
Est-ce grave si une page reste détectée mais non indexée ?
Pas forcément. Pour une URL récente ou secondaire, cela peut être normal. Pour une page stratégique qui reste bloquée longtemps, il faut vérifier le maillage interne, le sitemap, les logs, le serveur et la qualité de l’inventaire d’URL.
Faut-il demander l’indexation dans Search Console ?
Oui, mais seulement pour quelques URL importantes après vérification ou correction. Une demande d’indexation ne garantit pas le crawl immédiat ni l’entrée dans l’index.
Quelle différence avec “Explorée, actuellement non indexée” ?
Dans “Détectée”, Google connaît l’URL mais ne l’a pas encore explorée. Dans “Explorée”, Google a déjà récupéré la page, mais ne l’a pas ajoutée à l’index. Le diagnostic n’est donc pas le même.
Un sitemap suffit-il à faire explorer une URL ?
Non. Un sitemap aide Google à découvrir les URL, mais il ne garantit ni exploration ni indexation. Les liens internes, la qualité du site, la stabilité serveur et la priorité perçue comptent aussi.